


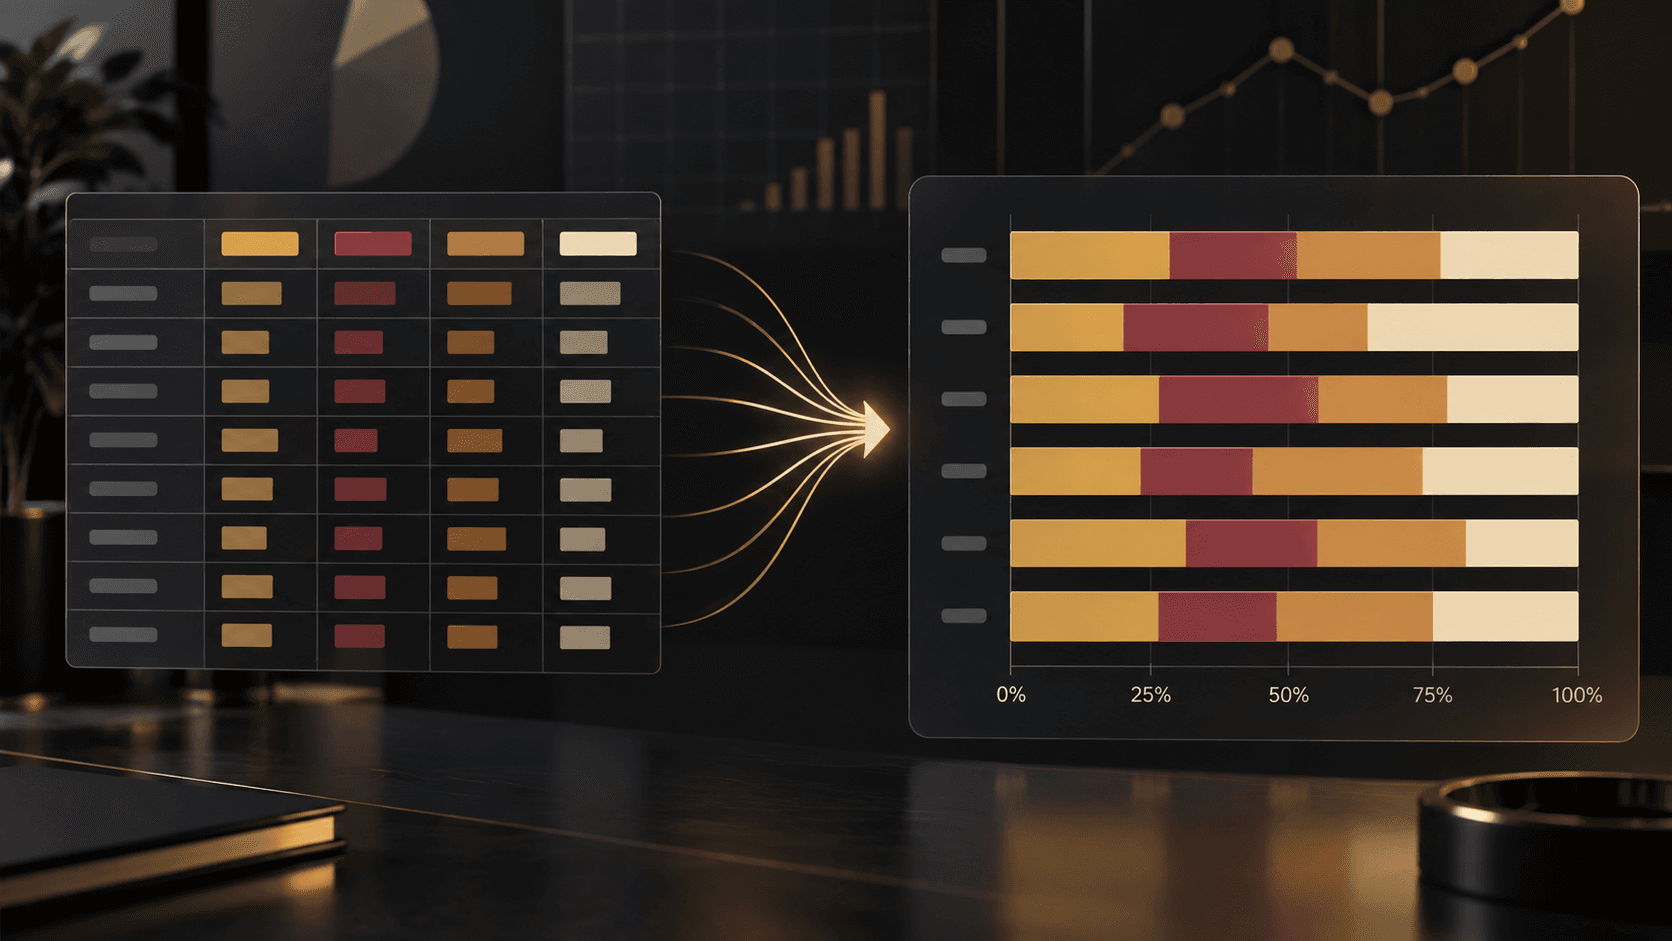
Cómo preparar los datos para crear una barra apilada al 100 % en Looker Studio
Cuando se trabaja con respuestas de una encuesta en Google Sheets, es común que la información llegue en varias columnas: cada columna representa un tema distinto y cada fila contiene una respuesta como Muy importante, Importante, Poco importante o Nada importante.
Esa estructura funciona bien para almacenar las respuestas, pero no siempre es la mejor para crear visualizaciones en Looker Studio. Para una barra apilada horizontal al 100 %, conviene reorganizar primero la información.
1. Reorganizar la información en Google Sheets
Para este tipo de visualización, primero se tiene la información de entrada organizada en formato horizontal dentro de Google Sheets. Cada columna representa un tema diferente y, debajo de cada encabezado, se encuentran las respuestas correspondientes.
La estructura inicial se ve de forma similar a esta:
Tema 1 Tema 2 Tema 3 Tema 4 Muy importante Muy importante Importante Muy importante Nada importante Poco importante Nada importante Importante Importante Muy importante Poco importante Muy importante Es decir:
- La primera fila contiene los nombres de los temas.
- Cada columna corresponde a un tema distinto.
- Las filas siguientes contienen las respuestas.
- Pueden existir celdas vacías cuando una persona no respondió algún elemento.
- Las categorías pueden ser, por ejemplo: Muy importante, Importante, Poco importante y Nada importante.
- La cantidad de filas puede seguir creciendo conforme se incorporen nuevas respuestas.
Esta estructura funciona correctamente para almacenar la información original, pero no es la más adecuada para generar directamente una gráfica de barras apiladas en Looker Studio.
Por eso, antes de crear la visualización, se debe reorganizar la información. Para que Looker Studio pueda trabajar fácilmente con estos datos, se transforma la información a una estructura de únicamente dos columnas:
- Tema
- Nivel de importancia
El resultado queda con una estructura similar a esta:
Tema Nivel de importancia Energías renovables Muy importante Movilidad eléctrica Muy importante Atracción de inversiones Importante Energías renovables Nada importante Movilidad eléctrica Importante De esta forma, cada respuesta queda registrada como una fila independiente y posteriormente se puede contar cuántas veces aparece cada nivel de importancia.
Fórmula para transformar los datos
En este ejemplo se utiliza la siguiente fórmula. Como en el artículo anterior, debes adaptar el nombre de la hoja, el rango de columnas y la fila donde comienzan tus datos.
- reorganizar-datos.gsheetsEXCEL
=QUERY(ARRAYFORMULA(SPLIT(FLATTEN('origen typeform'!L$1:R$1&"♦"&'origen typeform'!L2:R),"♦")),"SELECT Col1, Col2 WHERE Col2 IS NOT NULL LABEL Col1 'Tema', Col2 'Nivel de importancia'",0) ¿Qué parte corresponde al ejemplo?
En este caso, la información se encuentra en las columnas L a R de una hoja llamada origen typeform.
- hoja-y-rango.txtTEXT
origen typeform
Columnas: L a R
La parte
'origen typeform'!L$1:R$1toma los encabezados de las columnas. Es decir, toma los nombres de los elementos que después aparecerán dentro de la columna Tema.- encabezadosEXCEL
'origen typeform'!L$1:R$1 Mientras que
'origen typeform'!L2:Rtoma las respuestas correspondientes. Se comienza desde la fila 2 porque, en este ejemplo, la fila 1 contiene los encabezados y las respuestas empiezan en la fila 2.- respuestasEXCEL
'origen typeform'!L2:R ¿Cómo reutilizar la fórmula?
Si los datos se encuentran en otras columnas, únicamente se deben cambiar las referencias. Por ejemplo, si otra pregunta utiliza las columnas S a W, la fórmula sería:
- rango-S-WEXCEL
=QUERY(ARRAYFORMULA(SPLIT(FLATTEN('origen typeform'!S$1:W$1&"♦"&'origen typeform'!S2:W),"♦")),"SELECT Col1, Col2 WHERE Col2 IS NOT NULL LABEL Col1 'Tema', Col2 'Nivel de importancia'",0) La lógica es siempre la misma: los encabezados se toman de la fila 1 y las respuestas desde la fila 2.
- rango-S-W.txtTEXT
Encabezados:   S1:W1
Respuestas:    S2:W
Si la información estuviera, por ejemplo, entre las columnas C y H, se utilizarían los rangos
C1:H1para los encabezados yC2:Hpara las respuestas.Por lo tanto, para adaptar la fórmula a otros casos primero se debe identificar:
- la hoja donde se encuentran los datos;
- la primera y última columna que se quieren transformar;
- la fila donde están los encabezados;
- la fila donde comienzan las respuestas.
Cambiar el nombre de la hoja
Si la hoja no se llama
origen typeform, también se debe modificar esa parte. Por ejemplo, si la hoja se llama Respuestas encuesta, se utilizaría:- nombre-hoja-encabezadosEXCEL
'Respuestas encuesta'!L$1:R$1 - nombre-hoja-respuestasEXCEL
'Respuestas encuesta'!L2:R Las comillas simples son especialmente importantes cuando el nombre de la hoja contiene espacios.
Cambiar los nombres de las columnas resultantes
Al final de la fórmula aparece
LABEL Col1 'Tema', Col2 'Nivel de importancia'. Esta sección simplemente asigna un nombre a las dos columnas que se generan.- nombres-resultantesEXCEL
LABEL Col1 'Tema', Col2 'Nivel de importancia' En otro ejercicio podrían utilizarse otros nombres, por ejemplo Servicio y Nivel de satisfacción. En ese caso se modificaría por:
- labels-personalizadosEXCEL
LABEL Col1 'Servicio', Col2 'Nivel de satisfacción' Otro ejemplo podría ser Aspecto evaluado y Calificación. Por lo tanto, esta sección también puede personalizarse dependiendo del tipo de información que se esté analizando.
¿Qué hace automáticamente la fórmula?
- tomar los encabezados;
- relacionarlos con sus respuestas;
- convertir las columnas en filas;
- generar únicamente dos columnas;
- eliminar las respuestas vacías;
- mantener todas las respuestas registradas;
- incorporar automáticamente nuevos registros.
Esto último es especialmente útil porque se utilizan rangos abiertos como
L2:Ren lugar de rangos limitados comoL2:R100.- rango-abiertoEXCEL
L2:R - rango-limitadoEXCEL
L2:R100 Así, si posteriormente llegan más respuestas, no es necesario modificar la fórmula.
2. Llevar la información a Looker Studio
Una vez que la información ya está organizada en las dos columnas necesarias, se puede conectar la hoja con Looker Studio.
Dentro del reporte se selecciona:
Después se selecciona el archivo de Google Sheets, la hoja donde se generó la información reorganizada y la opción para utilizar la primera fila como encabezados.
Al conectar los datos, Looker Studio debe reconocer los dos campos creados anteriormente:
- campos-looker.txtTEXT
Tema
Nivel de importancia
Crear la gráfica
Una vez conectada la fuente, se agrega una gráfica de barras horizontales apiladas. Después se configuran los campos.
Dimensión
En Dimensión se selecciona:
- dimension.txtTEXT
Tema Esto hace que se genere una barra diferente para cada elemento.
Dimensión de desglose
En Dimensión de desglose se selecciona:
- dimension-desglose.txtTEXT
Nivel de importancia Esta configuración permite dividir cada barra según las distintas categorías existentes. Por ejemplo:
- categorias.txtTEXT
Nada importante
Poco importante
Importante
Muy importante
Métrica
Como métrica se utiliza:
- metrica.txtTEXT
Recuento de registros El recuento permite contabilizar cuántas veces aparece cada nivel de importancia dentro de cada tema. En términos simples, Looker Studio hará algo como:
- calculo-looker.txtTEXT
Tema + Nivel de importancia + Número de respuestas Con esa información construirá automáticamente las barras.
3. Configurar la gráfica como apilada al 100 %
Una vez creada la gráfica, el siguiente paso es hacer que todas las barras tengan la misma longitud. Para ello se selecciona la gráfica y se entra en Estilo → Apilamiento → 100 %.
Al utilizar esta opción, cada barra representa siempre el 100 % de las respuestas de ese tema. Así, aunque un tema tenga más respuestas que otro, ambos ocuparán el mismo espacio horizontal y lo que se comparará será la proporción de respuestas.
Cada sección representa una categoría diferente. La ventaja de utilizar una barra apilada al 100 % es que la comparación se vuelve mucho más sencilla, ya que se puede identificar rápidamente dónde existe una mayor concentración de respuestas positivas o negativas.
En lugar de comparar únicamente cantidades, se compara la distribución porcentual de cada tema.
De esta manera se obtiene una base más ordenada, reutilizable y preparada para construir gráficas apiladas al 100 % sin tener que reorganizar manualmente las respuestas cada vez que se actualice la información.